Предприятия помешаны на точности моделей, игнорируя при этом уровень инфраструктуры, где на самом деле ломаются ИИ-системы.


Самый дорогой сбой ИИ из всех, что я видел при развертывании в корпоративных средах, не сопровождался ошибками. Никакие оповещения не срабатывали. Ни одна панель мониторинга не окрашивалась в красный цвет. Система функционировала полностью исправно, она просто выдавала стабильные, уверенные и при этом абсолютно неверные результаты. В этом и заключается разрыв в надежности. И это та проблема, к обнаружению которой большинство корпоративных ИИ-программ сегодня не готовы.
Последние два года мы потратили на то, чтобы научиться эффективно оценивать модели: тесты производительности, показатели точности, проверки на устойчивость к атакам (red-team), тесты качества извлечения данных. Однако в продакшене система дает сбой реже всего именно на уровне самой модели. Сбои происходят на уровне инфраструктуры, питающих ее конвейеров данных, управляющей логики (оркестрации), систем поиска и сопоставления с источниками (retrieval), а также вложенных рабочих процессов, доверяющих полученным результатам. Этот уровень до сих пор мониторится с помощью инструментов, созданных для другого типа программного обеспечения.
Прорыв, который никто не измеряет
Эту проблему сложно заметить по одной простой причине: операционная исправность и поведенческая надежность — далеко не одно и то же, и большинство стеков мониторинга не способны уловить эту разницу.
Система может демонстрировать зеленые индикаторы по всем инфраструктурным метрикам (задержка в пределах SLA, нормальная пропускная способность, нулевой уровень ошибок), но при этом опираться на результаты поиска, устаревшие на шесть месяцев, незаметно переключаться на кэшированный контекст после сбоя вызова инструмента или транслировать неверную интерпретацию через пять шагов агентского рабочего процесса. Ничего из этого не отображается в Prometheus. Ничто из этого не приводит к срабатыванию оповещения в Datadog.
Причина очевидна: традиционная наблюдаемость создавалась для ответа на вопрос: «Работает ли сервис?» Корпоративный ИИ требует ответа на более сложный вопрос: «Ведет ли себя сервис корректно?» Это совершенно разные инструменты.
|
Что обычно измеряют команды |
Что на самом деле приводит к сбоям ИИ-инфраструктуры |
|
Время безотказной работы / задержка / уровень ошибок |
Актуальность извлеченных данных и степень доверия к источникам |
|
Использование токенов |
Целостность контекста в многоэтапных рабочих процессах |
|
Пропускная способность |
Семантический дрейф при реальной нагрузке |
|
Результаты бенчмарков модели |
Поведенческая стабильность при ухудшении условий |
|
Уровень инфраструктурных ошибок |
Скрытые частичные сбои на уровне рассуждений (reasoning) |
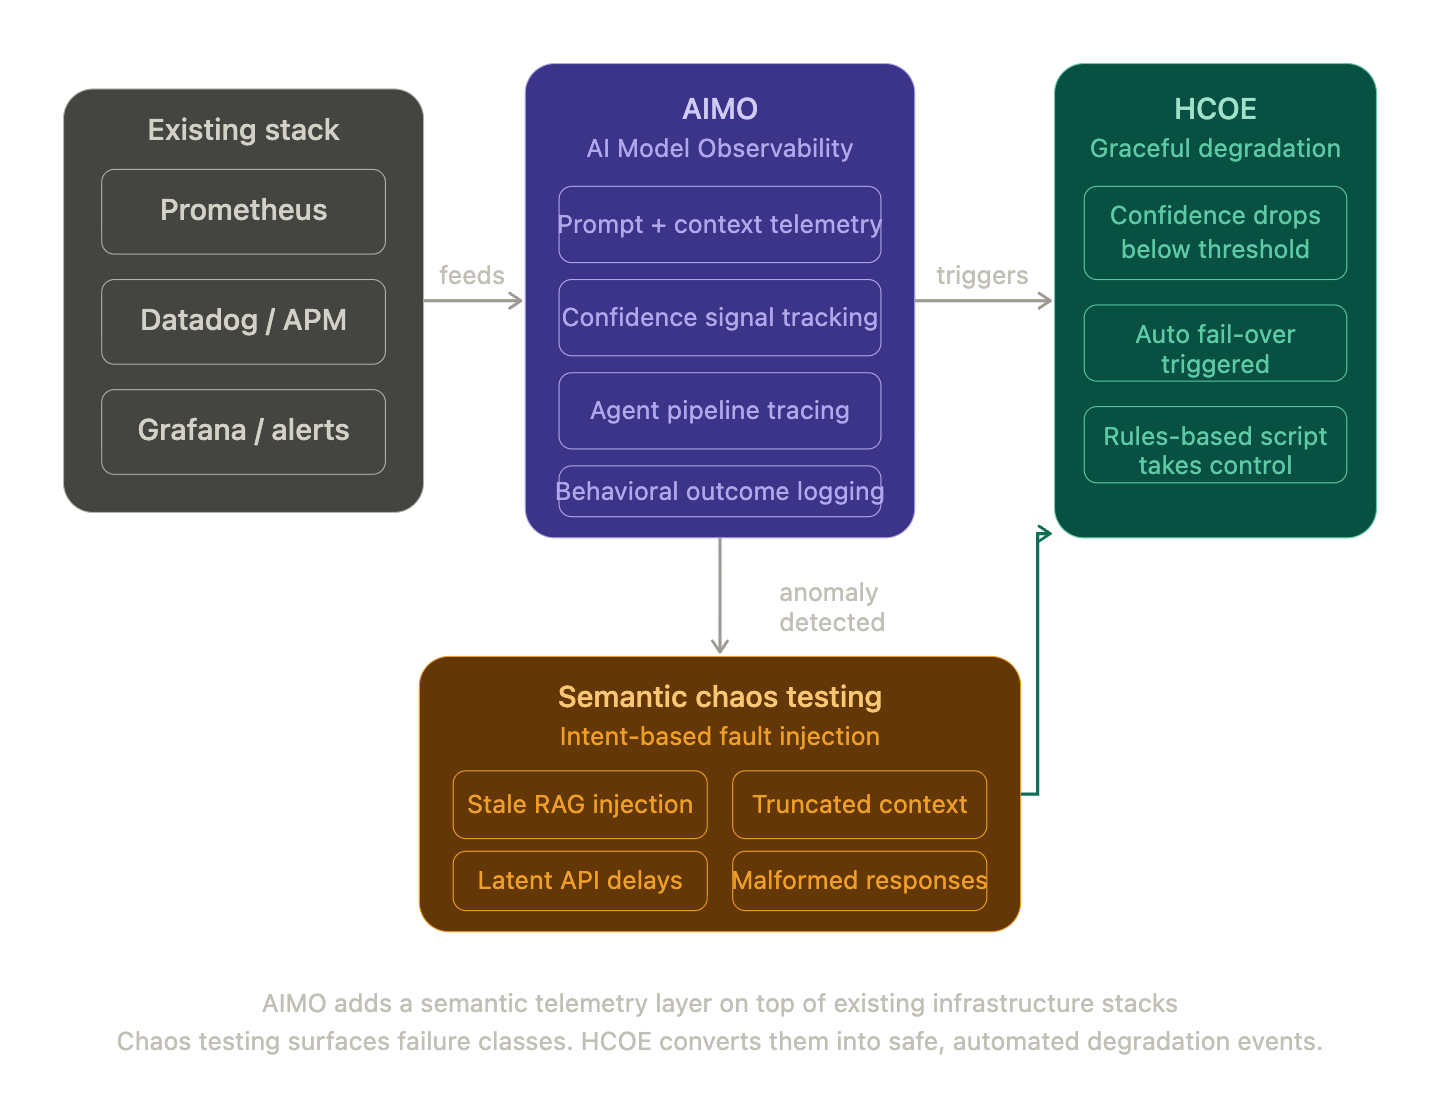
Устранение этого пробела требует добавления слоя поведенческой телеметрии в дополнение к инфраструктурному — не замены существующего, а его расширения с целью фиксации того, что именно модель сделала с полученным контекстом, а не только факта ответа сервиса.
Четыре типа сбоев, которые не фиксирует стандартный мониторинг
Анализируя развертывание корпоративного ИИ в сетевых операциях, логистике и на платформах наблюдаемости, я выделяю четыре закономерно повторяющихся паттерна сбоев.
Первый — деградация контекста. Модель делает выводы на основе неполных или устаревших данных так, что конечный пользователь ничего не замечает. Ответ выглядит безупречно. При этом опора на факты (grounding) полностью утеряна. Обнаружение обычно происходит недели спустя, через косвенные последствия, а не по системным алертам.
Второй — дрейф оркестрации. Агентские пайплайны редко ломаются из-за отказа какого-то одного компонента. Они дают сбой из-за того, что последовательность взаимодействий между поиском, инференсом, использованием инструментов и последующими действиями начинает расходиться под реальной нагрузкой. Система, казавшаяся стабильной при тестировании, ведет себя совершенно иначе, когда задержки накапливаются от шага к шагу, а граничные случаи (edge cases) накладываются друг на друга.
Третий — скрытый частичный сбой. Один из компонентов работает хуже нормы, но порог срабатывания алертов не превышен. Система начинает деградировать поведенчески раньше, чем операционно. Такие сбои незаметно накапливаются и проявляются сначала в виде потери доверия пользователей, а не в виде инцидент-тикетов. К моменту, когда информация доходит до разбора полетов (postmortem), эрозия процессов идет уже несколько недель.
Четвертый — радиус поражения автоматизации. В традиционном ПО локальный дефект остается локальным. В рабочих процессах на базе ИИ одна неверная интерпретация в начале цепочки может распространяться на последующие шаги, системы и бизнес-решения. Цена ошибки измеряется не только техническими издержками. Она становится организационной, и повернуть этот процесс вспять крайне сложно.
Метрики показывают, что произошло. Но они редко говорят о том, что едва не произошло.
Почему классического хаос-инжиниринга недостаточно и что нужно изменить
Традиционный хаос-инжиниринг задает правильный вопрос: что происходит, когда все ломается? Убить узел. Изолировать сегмент сети. Создать пиковую нагрузку на ЦП. Наблюдать. Эти тесты необходимы, и предприятия должны их проводить.
Но для ИИ-систем самые опасные сбои вызваны не аппаратными сбоями инфраструктуры. Они возникают на стыке качества данных, сборки контекста, рассуждений модели, логики оркестрации и последующих действий. Вы можете нагружать инфраструктуру тестами целыми днями и так и не выявить тот самый тип сбоя, который обходится вам дороже всего.
Тестированию надежности ИИ необходим уровень на основе намерений (intent-based): четко определять, что система должна делать в ухудшенных условиях, а не только тогда, когда все работает идеально. Затем нужно проверять конкретные сценарии, испытывающие эти намерения на прочность. Что произойдет, если поисковый слой вернет контент, который технически корректен, но устарел на шесть месяцев? Что произойдет, если агент-суммаризатор потеряет 30% своего контекстного окна из-за непредвиденного раздувания токенов на предыдущих этапах? Что произойдет, если вызов инструмента синтаксически успешен, но возвращает семантически неполные данные? Что произойдет, если агент повторяет попытку в деградировавшем рабочем процессе и с каждым шагом усугубляет собственную ошибку?
Эти сценарии — не редкие исключения. Именно так выглядит реальный продакшн. Это фреймворк, который я применял при создании систем надежности для корпоративной инфраструктуры: создание хаос-уровней на основе намерений для распределенных вычислительных сред. Главный вывод: именно намерение (intent), а не просто сбой, определяет характер теста.
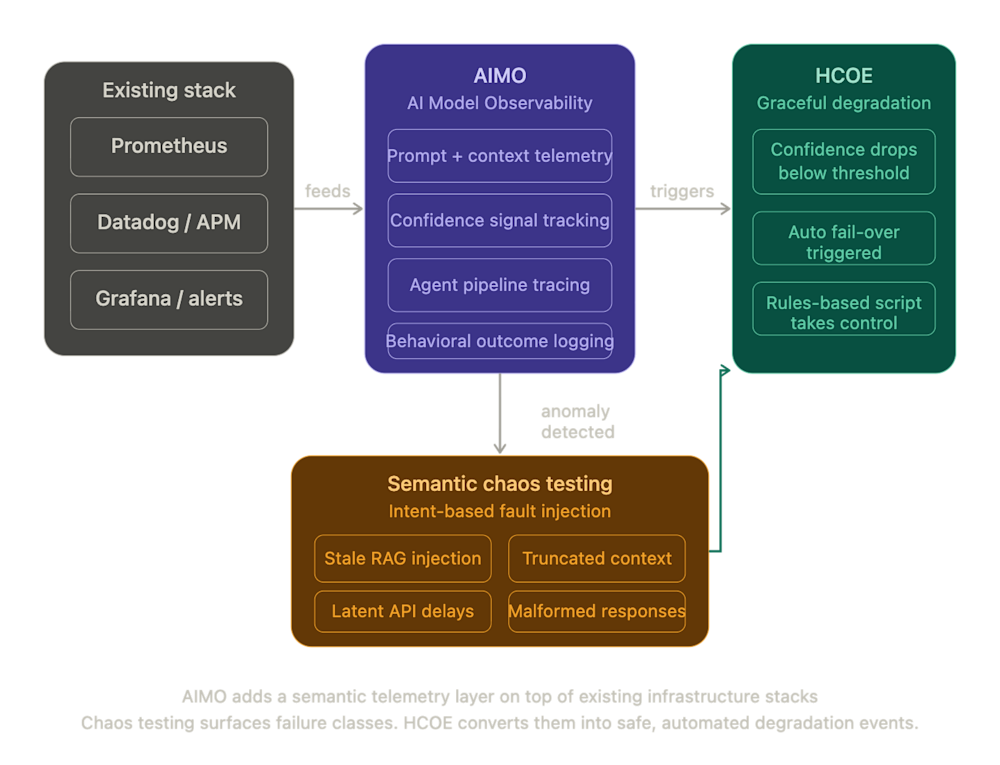
Изображение создано Саяли Патил с помощью Claude (Anthropic), собственность автора.
Что на самом деле требуется инфраструктурному слою
Все это не требует изобретения технологического стека заново. Требуется лишь расширить четыре составляющие.
Добавьте поведенческую телеметрию в дополнение к инфраструктурной. Отслеживайте, были ли ответы подкреплены фактами, срабатывало ли резервное поведение (fallback), падала ли уверенность модели ниже критического порога, соответствовал ли результат тому контексту, куда он был передан. Это тот самый слой наблюдаемости, который делает все остальное интерпретируемым.
Внедрите семантическое введение сбоев (fault injection) в пре-продакшн среды. Целенаправленно симулируйте устаревший поиск, неполную сборку контекста, деградацию вызовов инструментов и нагрузку на границы токенов. Цель состоит не в показушном хаосе. Цель — выяснить, как ведет себя система в условиях, которые чуть хуже, чем ваша тестовая среда, — то есть ровно в таких условиях, в которых всегда работает продакшн.
Определите условия безопасной остановки (halt conditions) до развертывания, а не после первого инцидента. ИИ-системам необходим аналог автоматических выключателей (circuit breakers) на уровне рассуждений. Если система не может поддерживать опору на факты, проверить целостность контекста или завершить рабочий процесс с достаточной для доверия степенью уверенности, она должна корректно остановиться, пометить ошибку и передать управление человеку или детерминированному запасному алгоритму. Изящная остановка почти всегда безопаснее уверенно поданной ошибки. Слишком многие системы запрограммированы на продолжение работы просто потому, что уверенный тон ответа создает иллюзию правильности.
Распределите общую ответственность за сквозную надежность. Самый распространенный организационный сбой — четкое разделение команд разработки моделей, платформенных команд, специалистов по данным и прикладных разработчиков. Когда система работает на уровне инфраструктуры, но выдает сбои в логике, за это никто конкретно не отвечает. Семантический сбой нуждается в ответственном лице. Без этого ошибки будут накапливаться.
Кривая зрелости меняется
Последние два года главным конкурентным преимуществом корпоративного ИИ было внедрение — кто быстрее доберется до продакшена. Этот этап подходит к концу. По мере того как модели превращаются в стандартизированный товар (commoditization), а базовые возможности выравниваются, конкурентное преимущество будет приходить из того, что скопировать гораздо сложнее: способности надежно использовать ИИ в масштабе, в реальных условиях и с реальными последствиями.
Вчерашним дифференциатором было внедрение самой модели. Сегодняшним — системная интеграция. Завтрашним станет надежность в условиях стресса в продакшене.
Предприятия, которые придут к этому первыми, будут обладать не самыми передовыми моделями. У них будет самая дисциплинированная инфраструктура — инфраструктура, протестированная в условиях, с которыми ей действительно придется столкнуться, а не в тех лабораторных условиях, которые делали пилотный проект привлекательным.
Модель — это еще не все риски. Главные риски кроются в не протестированной системе вокруг нее.
Саяли Патил — эксперт в области ИИ-инфраструктуры и продуктовый лидер.
Добро пожаловать в сообщество VentureBeat!
Наша программа гостевых публикаций — это площадка, где технические эксперты делятся идеями и публикуют независимые, неангажированные аналитические материалы об искусственном интеллекте, инфраструктуре данных, кибербезопасности и других передовых технологиях, формирующих будущее бизнеса.
Читайте больше материалов из нашей программы гостевых публикаций и ознакомьтесь с нашими рекомендациями, если вы хотите предложить собственную статью!