RAE от Нью-Йоркского университета повышает эффективность диффузионных моделей


Исследователи из Нью-Йоркского университета разработали новую архитектуру для диффузионных моделей, которая улучшает семантическое представление создаваемых ими изображений. «Диффузионный трансформер с автоэнкодерами представлений» (Diffusion Transformer with Representation Autoencoders, RAE) бросает вызов некоторым устоявшимся нормам создания диффузионных моделей. Модель исследователей из NYU оказалась эффективнее и точнее стандартных диффузионных моделей, использует последние достижения в области обучения представлений и может проложить путь к новым приложениям, которые раньше были слишком сложными или дорогостоящими.
Этот прорыв может открыть более надежные и мощные возможности для корпоративных приложений. «Чтобы качественно редактировать изображения, модель должна действительно понимать, что на них изображено, — рассказал соавтор научной работы Сайнинг Се (Saining Xie) изданию VentureBeat. — RAE помогает связать эту часть понимания с частью генерации». Он также указал на будущие применения в «генерации на основе RAG, где функции энкодера RAE используются для поиска, а затем генерируются новые изображения на основе результатов поиска», а также в «генерации видео и мировых моделях, управляемых действиями».
Состояние генеративного моделирования
Диффузионные модели — технология, лежащая в основе большинства современных мощных генераторов изображений, — рассматривают генерацию как процесс обучения сжатию и распаковке изображений. Вариационный автоэнкодер (VAE) изучает компактное представление ключевых признаков изображения в так называемом «латентном пространстве». Затем модель обучается генерировать новые изображения путем обращения этого процесса из случайного шума.
В то время как диффузионная часть этих моделей продвинулась вперед, автоэнкодер, используемый в большинстве из них, в последние годы практически не изменился. По словам исследователей из NYU, этот стандартный автоэнкодер (SD-VAE) подходит для захвата низкоуровневых признаков и локального внешнего вида, но ему не хватает «глобальной семантической структуры, имеющей решающее значение для генерализации и генеративной производительности».
В то же время в области обучения представлений изображений произошел впечатляющий прогресс благодаря таким моделям, как DINO, MAE и CLIP. Эти модели изучают семантически структурированные визуальные признаки, которые обобщаются для разных задач и могут служить естественной основой для визуального понимания. Однако широко распространенное мнение удерживало разработчиков от использования этих архитектур в генерации изображений: модели, ориентированные на семантику, не подходят для создания изображений, поскольку они не улавливают детализированные признаки на уровне пикселей. Практики также считают, что диффузионные модели плохо работают с теми высокоразмерными представлениями, которые создают семантические модели.
Диффузия с энкодерами представлений
Исследователи из NYU предлагают заменить стандартный VAE «автоэнкодерами представлений» (RAE). Этот новый тип автоэнкодера объединяет предварительно обученный энкодер представлений, такой как DINO от Meta, с обученным декодером визуального трансформера. Такой подход упрощает процесс обучения за счет использования существующих мощных энкодеров, которые уже были обучены на масситивных наборах данных.
Чтобы это заработало, команда разработала вариант диффузионного трансформера (DiT), который является основой большинства моделей генерации изображений. Этот модифицированный DiT можно эффективно обучать в высокоразмерном пространстве RAE без огромных затрат на вычисления. Исследователи показывают, что замороженные энкодеры представлений, даже оптимизированные для семантики, могут быть адаптированы для задач генерации изображений. Их метод дает реконструкции, которые превосходят стандартный SD-VAE без добавления архитектурной сложности.
Однако внедрение этого подхода требует изменения мышления. «RAE — это не простой автоэнкодер по принципу «подключи и работай»; диффузионная часть модели также должна развиваться, — пояснил Се. — Один из ключевых моментов, который мы хотим подчеркнуть, заключается в том, что моделирование латентного пространства и генеративное моделирование должны проектироваться совместно, а не рассматриваться по отдельности».
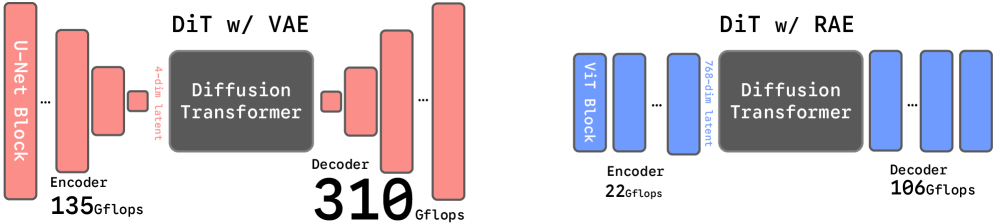
Исследователи обнаружили, что при правильных архитектурных корректировках представления более высокой размерности становятся преимуществом, обеспечивая более богатую структуру, более быструю сходимость и лучшее качество генерации. В своей работе исследователи отмечают, что эти «высокоразмерные латентные переменные практически не создают дополнительных затрат на вычисления или память». Кроме того, стандартный SD-VAE обходится дороже в вычислительном отношении: по сравнению с RAE ему требуется примерно в шесть раз больше вычислений для энкодера и в три раза больше для декодера.
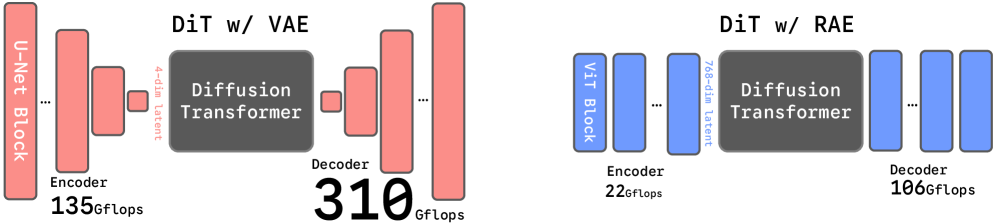
Архитектура RAE гораздо эффективнее классической VAE и требует значительно меньших вычислительных затрат (источник: arXiv)
Более высокая производительность и эффективность
Новая архитектура модели обеспечивает значительный прирост как эффективности обучения, так и качества генерации. Усовершенствованный диффузионный рецепт команды дает отличные результаты уже после 80 эпох обучения. По сравнению с предыдущими диффузионными моделями, обученными на VAE, модель на базе RAE обеспечивает 47-кратное ускорение обучения. Она также превосходит недавние методы, основанные на выравнивании представлений, обеспечивая 16-кратное ускорение обучения. Такой уровень эффективности напрямую преобразуется в более низкие затраты на обучение и более быстрые циклы разработки моделей.
Для корпоративного использования это означает более надежные и стабильные результаты. Се отметил, что модели на базе RAE менее склонны к семантическим ошибкам, наблюдаемым в классической диффузии, и добавил, что RAE дает модели «гораздо более умный взгляд на данные». Он заметил, что ведущие модели, такие как ChatGPT-4o и Nano Banana от Google, движутся в сторону «предметно-ориентированной, высококонсистентной генерации с расширенными знаниями», и что семантически богатая основа RAE является ключом к достижению такой надежности в масштабе и в открытых моделях.
Исследователи продемонстрировали эту производительность на бенчмарке ImageNet. Используя метрику Fréchet Inception Distance (FID), где более низкий балл указывает на более высокое качество изображений, модель на базе RAE достигла передового результата в 1,51 балла без гайданса (guidance). С использованием AutoGuidance — техники, которая использует меньшую модель для управления процессом генерации, — показатель FID упал до еще более впечатляющих 1,13 как для изображений 256×256, так и 512×512.
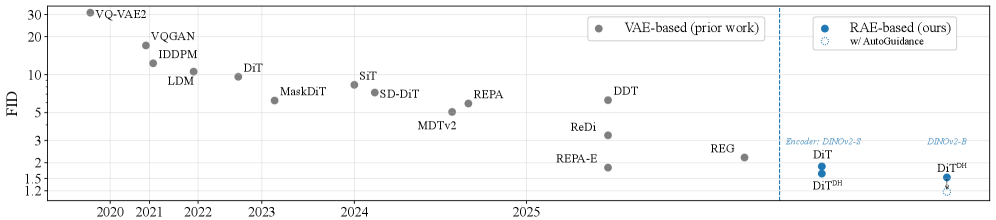
Производительность RAE в сравнении с классической VAE (источник: arXiv)
Успешно интегрировав современное обучение представлений в диффузионный фреймворк, эта работа открывает новый путь для создания более мощных и экономичных генеративных моделей. Это объединение указывает на будущее более интегрированных систем ИИ.
«Мы верим, что в будущем появится единая универсальная модель представления, которая захватывает богатую лежащую в основе структуру реальности… способную декодировать в самые разные модальности вывода», — сказал Се. Он добавил, что RAE предлагает уникальный путь к этой цели: «Высокоразмерное латентное пространство должно изучаться отдельно, чтобы обеспечить надежный априор, который затем можно декодировать в различные модальности, а не полагаться на грубый подход смешивания всех данных и обучения с несколькими целями одновременно».