SPICE от Meta FAIR выводит самообучение ИИ на новый уровень


Исследователи из Meta FAIR и Национального университета Сингапура разработали новый фреймворк обучения с подкреплением для самосовершенствующихся систем искусственного интеллекта.
Фреймворк, получивший название Self-Play In Corpus Environments (SPICE), сталкивает двух ИИ-агентов друг с другом, создавая собственные задачи и постепенно совершенствуясь без участия человека.
Хотя в настоящее время это лишь концептуальное доказательство, такой механизм самоигры может стать основой для будущих систем ИИ, способных динамически адаптироваться к окружающей среде, что сделает их более устойчивыми к непредсказуемости реальных сценариев применения.
Проблема самосовершенствующегося ИИ
Цель самосовершенствующегося ИИ заключается в создании систем, способных расширять свои возможности за счет взаимодействия с окружающей средой.
Распространенным подходом является обучение с подкреплением и верифицируемыми наградами (RLVR), при котором модели получают вознаграждение за предоставление правильных ответов на задачи. Этот метод часто ограничен зависимостью от созданных человеком наборов проблем и специфической для конкретной предметной области инженерии вознаграждений, что затрудняет его масштабирование.
Самоигра (self-play), когда модель совершенствуется, соревнуясь сама с собой, — это еще одна перспективная парадигма. Однако существующие методы самоигры для языковых моделей часто ограничены двумя критическими факторами.
-
Фактические ошибки в сгенерированных вопросах и ответах накапливаются, приводя к замкнутому кругу галлюцинаций.
-
Когда генератор проблем и решатель обладают информационной симметрией (т. е. разделяют одну и ту же базу знаний), они не могут создавать по-настоящему новые задачи и скатываются в повторяющиеся паттерны.
Как отмечают исследователи в своей статье: «Эти систематические эмпирические сбои показывают, что самосовершенствование требует взаимодействия с внешним источником, предоставляющим разнообразную, проверяемую обратную связь, а не чистой интроспекции по замкнутому циклу».
Как работает SPICE
SPICE — это фреймворк самоигры, в котором одна и та же модель выполняет две разные роли.
Такая конфигурация разрушает информационную симметрию, которая ограничивает другие методы самоигры, поскольку Решатель (Reasoner) не имеет доступа к документам и знаниям, которые Претендент (Challenger) использует для генерации задач.
Опора задач на обширный и разнообразный корпус документов предотвращает галлюцинации, фиксируя вопросы и ответы в контенте реального мира. Это важно, потому что для надежного самосовершенствования систем ИИ им необходимы внешние источники обоснования. Следовательно, агентам на базе LLM следует учиться во взаимодействии с людьми и реальным миром, а не только на собственных результатах, чтобы избегать накопления ошибок.
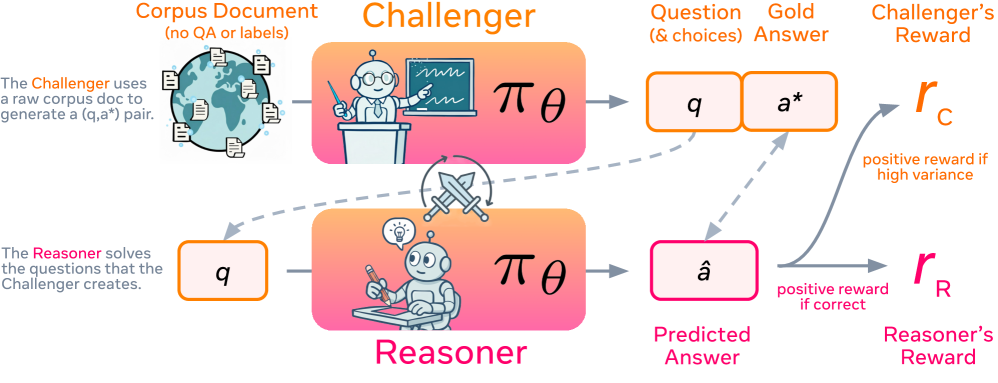
Фреймворк SPICE (источник: arXiv)
Состязательная динамика между двумя ролями создает автоматическую учебную программу.
Претендент получает вознаграждение за генерацию задач, которые одновременно разнообразны и находятся на переднем крае возможностей Решателя (не слишком просты и не невозможны).
Решатель получает вознаграждение за правильные ответы. Это симбиотическое взаимодействие подталкивает обоих агентов к непрерывному открытию и преодолению новых трудностей.
Поскольку система использует исходные документы вместо предопределенных пар «вопрос-ответ», она может генерировать задачи в различных форматах, таких как вопросы с множественным выбором и свободной формой.
Эта гибкость позволяет применять SPICE в любой предметной области, преодолевая узкое место, которое ограничивало предыдущие методы такими узкими сферами, как математика и код. Она также снижает зависимость от дорогих наборов данных, созданных людьми для специализированных областей, таких как юридический или медицинский анализ.
SPICE в действии
Исследователи оценили работу SPICE на нескольких базовых моделях, включая Qwen3-4B-Base и OctoThinker-3B-Hybrid-Base.
Его производительность сравнивалась с базовыми показателями, такими как базовая модель без обучения, модель Решателя, обученная с фиксированным «Сильным Претендентом» (Qwen3-32B-Instruct), и методы чистой самоигры, такие как R-Zero и Absolute Zero. Оценка охватывала широкий спектр тестов на математические и общие рассуждения.
Во всех моделях SPICE стабильно превосходил базовые показатели, обеспечивая значительные улучшения как в задачах на математические, так и на общие рассуждения.
Результаты показывают, что возможности рассуждения, развитые с помощью корпусно-обоснованной самоигры, широко переносятся на разные модели благодаря использованному ими разнообразному корпусу внешних знаний.
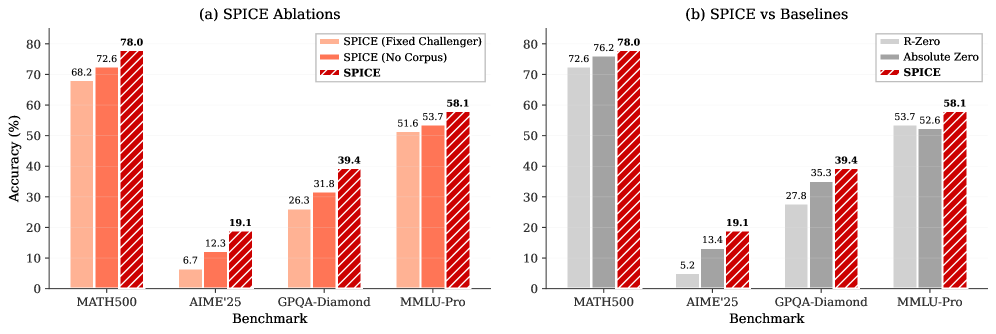
Производительность SPICE (источник: arXiv)
Ключевой вывод заключается в том, что состязательная динамика создает эффективную автоматическую учебную программу. По мере прохождения обучения Претендент учится генерировать все более сложные задачи.
В одном из экспериментов процент успешных прохождений Решателя на фиксированном наборе задач со временем увеличился с 55% до 85%, продемонстрировав рост его возможностей.
Между тем, более поздние версии Претендента смогли генерировать вопросы, которые снизили процент успешных прохождений Решателя на ранней стадии с 55% до 35%, подтверждая, что обе роли успешно эволюционируют вместе.
Исследователи приходят к выводу, что этот подход представляет собой смену парадигмы в методах самосовершенствующихся рассуждений — «от самоигры по замкнутому циклу, которая часто стагнирует из-за дрейфа галлюцинаций, к открытому совершенствованию через взаимодействие с обширными, верифицируемыми знаниями, заложенными в корпусах веб-документов».
В настоящее время корпус, используемый для SPICE, представляет человеческий опыт, запечатленный в тексте. Конечная цель состоит в том, чтобы самосовершенствующиеся системы генерировали вопросы на основе взаимодействия с реальностью, включая физический мир, интернет и человеческое взаимодействие в различных модальностях, таких как видео, аудио и данные датчиков.