Agent-R1 повышает эффективность обучения языковых моделей для сложных задач


Исследователи из Научно-технического университета Китая разработали новый фреймворк обучения с подкреплением (RL), который помогает обучать большие языковые модели (LLM) для сложных автономных задач (agentic tasks), выходящих за рамки четко определенных проблем, таких как математика и программирование.
Их фреймворк, Agent-R1, совместим с популярными алгоритмами обучения с подкреплением и демонстрирует значительное улучшение в задачах на рассуждение, требующих многократных этапов поиска и многошагового взаимодействия с инструментами.
Фреймворк построен на переосмыслении парадигмы обучения с подкреплением, которая учитывает динамическую природу агентных приложений, требующих взаимодействия с меняющейся средой и неполной информацией. Такой подход гораздо больше похож на реальные сценарии применения и может иметь важное значение для автономных задач в корпоративной среде.
Переосмысление обучения с подкреплением для агентов
Обучение с подкреплением стало краеугольным камнем обучения LLM для четко определенных задач на рассуждение. В таких областях, как математика и программирование, модель получает четкий сигнал: ответ либо правильный, либо нет. Это делает задачу вознаграждения или штрафа за поведение относительно простой.
Но этот подход с трудом справляется с автономными задачами, требующими от моделей работы в интерактивных средах, создания динамической памяти в ходе диалогов, выполнения многошагового рассуждения и реагирования на непредсказуемую обратную связь. Обучение агентов с помощью RL для таких сценариев сопряжено с уникальными трудностями, особенно при многошаговых взаимодействиях, где разработка эффективных вознаграждений сложна, а обученный агент часто оказывается неспособен адаптироваться к хаотичной, непредсказуемой природе реальной среды.
Чтобы решить эти проблемы, исследователи из Научно-технического университета обратились к фундаментальной основе обучения с подкреплением, известной как марковский процесс принятия решений (MDP). MDP моделирует принятие решений с помощью четырех ключевых компонентов: пространства состояний (набор возможных состояний, в которых может находиться агент); пространства действий (что агент может сделать); вероятности перехода между состояниями (состояние, к которому, скорее всего, приведет действие); и функции вознаграждения (хороший или плохой результат). В статье предлагается расширить эту структуру, чтобы лучше адаптировать ее для агентов на базе LLM.
В новой формулировке пространство состояний расширено и включает в себя не только текущее состояние (текущую последовательность токенов, сгенерированных моделью), но и всю историю взаимодействий и обратной связи от окружающей среды. Действия по-прежнему в основном заключаются в генерации текста, но теперь определенные последовательности текста могут вызывать внешние инструменты, такие как вызов API. Переходы между состояниями становятся непредсказуемыми или «стохастическими», поскольку результат зависит не только от токенов, предсказанных моделью, но и от отклика среды, который определяется внешними факторами. Наконец, система вознаграждения становится более детализированной, включая промежуточные «вознаграждения за процесс» за успешное прохождение промежуточных этапов, а не только единовременное вознаграждение в самом конце. Это обеспечивает более частые и точные указания для агента во время обучения.
Этот последний аспект особенно важен и решает проблему «редкого вознаграждения» (sparse reward), с которой сталкивается большинство фреймворков RL. Когда агент получает единственный сигнал вознаграждения на основе финального результата, он не учится на правильных и неправильных промежуточных шагах, которые он предпринял на пути к нему. Вознаграждения за процесс решают эту проблему, предоставляя сигналы обратной связи по этим промежуточным шагам, что делает процесс обучения гораздо более эффективным.
«Эти расширения имеют решающее значение для того, чтобы алгоритмы обучения с подкреплением могли обучать сложные агенты, способные к многошаговым рассуждениям и взаимодействию в динамичной среде», — пишут исследователи в своей статье.
Фреймворк Agent-R1
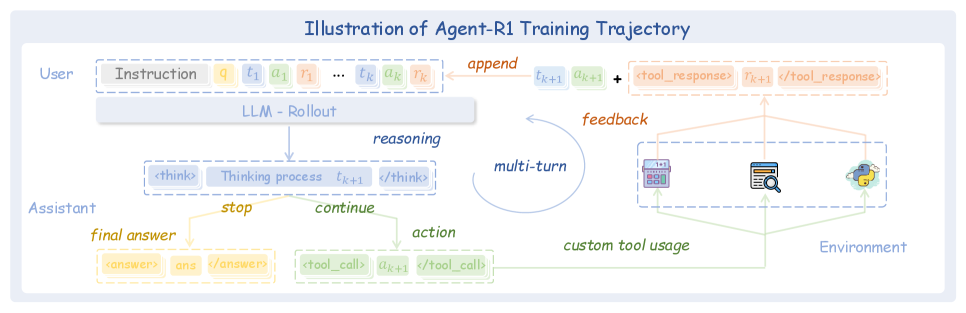
Опираясь на расширенное определение MDP, исследователи разработали Agent-R1 — гибкую и удобную в использовании тренировочную платформу для LLM-агентов на базе RL. Она расширяет традиционные одношаговые фреймворки RL, позволяя им справляться с многошаговой, интерактивной природой автономных задач и обеспечивая бесшовную интеграцию с различными средами.
Самое существенное различие заключается в «фазе развертывания» (rollout phase), на которой агент генерирует ответы. В одношаговом RL модель генерирует ответ один курс. В многошаговом RL этот процесс включает в себя серию сложных двусторонних взаимодействий.
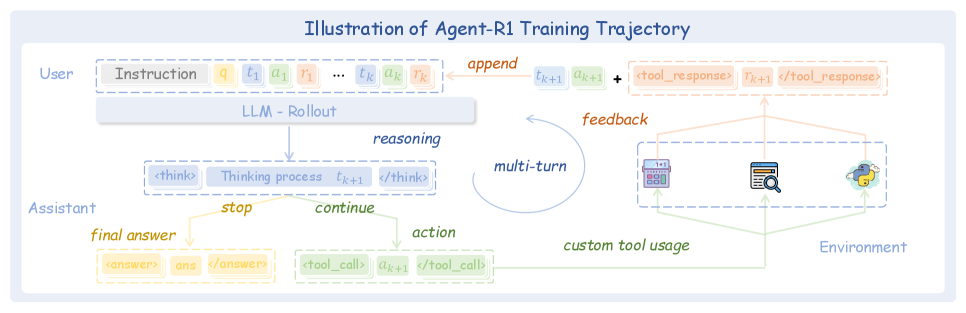
Фреймворк Agent-R1 (источник: arXiv)
Agent-R1 реализует этот гибкий многошаговый процесс с помощью двух основных модулей: Tool и ToolEnv. Модуль Tool выступает в качестве исполнителя конкретных действий, таких как вызов API или доступ к базе данных. При вызове Tool выполняет свое действие и возвращает прямой необработанный результат. Напротив, модуль ToolEnv является координатором и интерпретатором. Он принимает вывод от Tool и определяет, как этот результат влияет на состояние агента и общий прогресс выполнения задачи. ToolEnv управляет переходами между состояниями, рассчитывает сигналы вознаграждения на основе результатов работы инструментов и упаковывает информацию о новом состоянии для агента.
Кратко говоря, когда действие завершено, Tool сообщает «что произошло», в то время как ToolEnv определяет, «что этот результат означает для агента и задачи».
Agent-R1 в действии
Исследователи протестировали Agent-R1 на сложной задаче многошагового ответа на вопросы (multi-hop question answering), которая требует сложных рассуждений, поиска информации по нескольким документам и многошагового принятия решений. Они обучили Qwen2.5-3B-Instruct на датасетах для вопросов и ответов (QA) и оценили его производительность на наборах данных HotpotQA и 2WikiMultihopQA. Они также протестировали модель на датасете Musique, который находился вне зоны задач, на которых обучался агент.
Они сравнили различные алгоритмы RL, обученные с помощью Agent-R1, с двумя базовыми моделями: Naive RAG, методом однопроходного поиска, где LLM отвечает на основе одного набора извлеченных документов, и Base Tool Call, который использует встроенную способность модели вызывать функции без специализированного обучения RL.
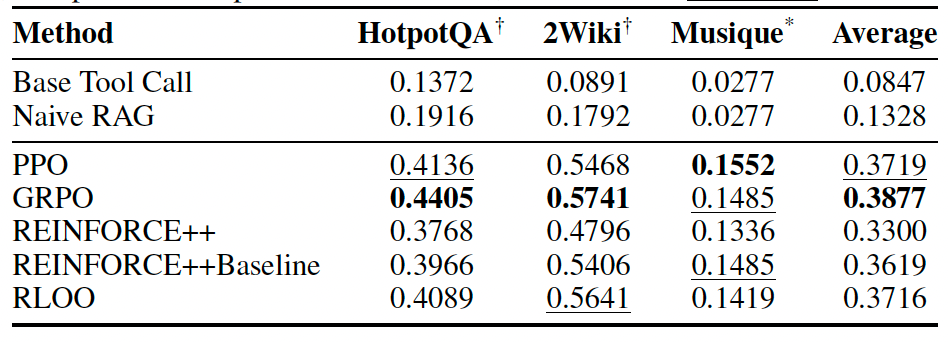
Модели, обученные с использованием фреймворка Agent-R1 (ниже горизонтальной линии), значительно превосходят базовые показатели (источник: arXiv)
Результаты показали, что все агенты, обученные с помощью RL, существенно превзошли базовые показатели. GRPO, алгоритм RL, используемый в передовых моделях рассуждения, таких как DeepSeek-R1, продемонстрировал лучшие общие результаты.
«Эти результаты убедительно подтверждают эффективность Agent-R1 в обучении мощных LLM-агентов с помощью сквозного обучения с подкреплением, демонстрируя стабильный и существенный прирост по сравнению с базовыми показателями на различных наборах данных и алгоритмах RL», — пишут исследователи.
Эти выводы могут иметь большое значение для корпоративного сектора, где наблюдается сильный стимул применять RL и рассуждения за пределами четко определенных предметных областей. Фреймворк, созданный для работы с запутанными многошаговыми взаимодействиями с пользователями и динамической средой, может проложить путь к созданию новых агентов, способных решать сложные проблемы в реальных условиях.
«Мы надеемся, что Agent-R1 послужит основой для будущих работ по масштабируемому и унифицированному обучению с подкреплением для автономных LLM», — заключают исследователи.