AgentEvolver от Alibaba повышает эффективность обучения ИИ
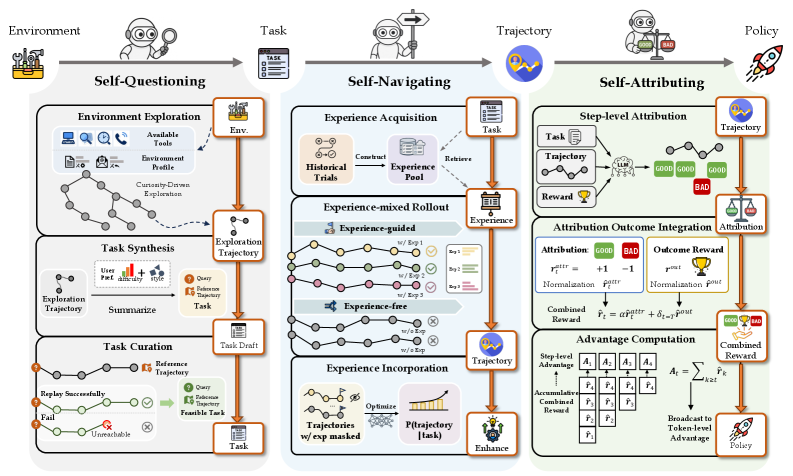


Исследователи из лаборатории Tongyi компании Alibaba разработали новый фреймворк для саморазвивающихся агентов, которые создают собственные обучающие данные путем исследования сред своего применения. Фреймворк AgentEvolver использует знания и возможности рассуждения больших языковых моделей для автономного обучения, решая проблему высоких затрат и ручного труда, которые обычно требуются для сбора наборов данных под конкретные задачи.
Эксперименты показывают, что по сравнению с традиционными фреймворками на основе обучения с подкреплением AgentEvolver более эффективен в исследовании среды, лучше использует данные и быстрее адаптируется к условиям приложений. Для бизнеса это имеет важное значение, так как снижает барьер для обучения агентов под индивидуальные задачи, делая мощные заказные ИИ-ассистенты более доступными для широкого круга организаций.
Высокая стоимость обучения ИИ-агентов
Обучение с подкреплением стало ключевой парадигмой для тренировки больших языковых моделей (LLM) с целью создания агентов, способных взаимодействовать с цифровыми средами и учиться на основе обратной связи. Однако разработка агентов с помощью обучения с подкреплением сталкивается с фундаментальными проблемами. Во-первых, сбор необходимых обучающих данных зачастую обходится непомерно дорого и требует значительного ручного труда для создания примеров задач, особенно в новых или проприетарных программных средах, где отсутствуют готовые наборы данных.
Во-вторых, методы обучения с подкреплением, обычно применяемые для LLM, требуют от модели прохождения через огромное количество попыток и ошибок для эффективного обучения. Этот процесс является вычислительно затратным и неэффективным. В результате обучение способных LLM-агентов посредством обучения с подкреплением остается трудоемким и дорогостоящим, что ограничивает их развертывание в корпоративных средах на заказ.
Как работает AgentEvolver
Основная идея AgentEvolver заключается в том, чтобы предоставить моделям большую автономность в их собственном процессе обучения. Исследователи описывают его как «систему саморазвивающихся агентов», предназначенную для «достижения автономной и эффективной эволюции возможностей посредством взаимодействия с окружающей средой». Он использует возможности рассуждения LLM для создания цикла самообучения, позволяя агенту непрерывно совершенствоваться путем прямого взаимодействия с целевой средой без необходимости использования предопределенных задач или функций вознаграждения.
«Мы представляем себе агентную систему, в которой LLM активно направляет исследование, генерацию задач и улучшение производительности», — написали исследователи в своей научной работе.
Процесс самоэволюции управляется тремя ключевыми механизмами, которые работают в комплексе.
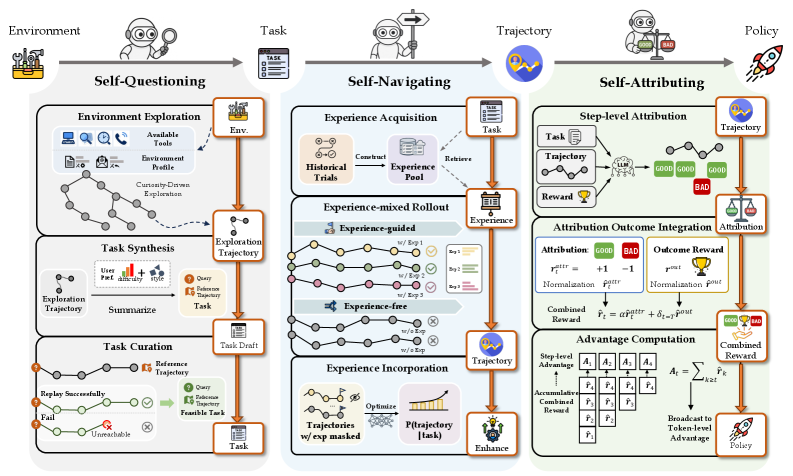
Фреймворк AgentEvolver (источник: arXiv)
Первый механизм — это самоопрос (self-questioning), при котором агент исследует свое окружение, чтобы обнаружить границы своих функций и определить полезные состояния. Это похоже на то, как новый пользователь кликает по элементам приложения, чтобы узнать, что в нем возможно. На основе этого исследования агент генерирует собственный разнообразный набор задач, соответствующих общим предпочтениям пользователя. Это снижает потребность в создании наборов данных вручную и позволяет агенту и его задачам эволюционировать совместно, постепенно давая ему возможность справляться с более сложными проблемами.
По словам Юньпэна Чжая (Yunpeng Zhai), исследователя из Alibaba и соавтора научной работы, который дал интервью изданию VentureBeat, механизм самоопроса эффективно превращает модель из «потребителя данных в производителя данных», кардинально сокращая время и затраты, необходимые для развертывания агента в проприетарной среде.
Второй механизм — самонавигация (self-navigating), которая повышает эффективность исследования за счет повторного использования и обобщения прошлого опыта. AgentEvolver извлекает выводы как из успешных, так и из неудачных попыток и использует их для направления будущих действий. Например, если агент пытается использовать функцию API, которой не существует в приложении, он регистрирует это как опыт и учится проверять существование функций перед тем, как пытаться использовать их в дальнейшем.
Третий механизм, самоатрибуция (self-attributing), повышает эффективность обучения за счет предоставления более детальной обратной связи. Вместо простого сигнала об окончательном успехе или неудаче (распространенная практика в обучении с подкреплением, которая может приводить к разреженным вознаграждениям), этот механизм использует LLM для оценки вклада каждого отдельного действия в многошаговой задаче. Он ретроспективно определяет, внес ли каждый шаг положительный или отрицательный вклад в конечный результат, предоставляя агенту детализированную обратную связь, которая ускоряет обучение.
Это имеет решающее значение для регулируемых отраслей, где то, как агент решает проблему, так же важно, как и результат. «Вместо того чтобы вознаграждать студента только за финальный ответ, мы также оцениваем ясность и правильность каждого шага в его рассуждениях», — пояснил Чжай. Это повышает прозрачность и побуждает агента применять более надежные и проверяемые паттерны решения проблем.
«Перенося инициативу обучения с созданных человеком пайплайнов на самоулучшение под руководством LLM, AgentEvolver формирует новую парадигму, прокладывающую путь к масштабируемым, экономически эффективным и непрерывно совершенствующимся интеллектуальным системам», — заявляют исследователи.
Команда также разработала практический сквозной обучающий фреймворк, объединяющий эти три механизма. Ключевой частью этой основы является диспетчер контекста (Context Manager) — компонент, который управляет памятью агента и историей взаимодействия. В то время как современные бенчмарки тестируют ограниченное количество инструментов, реальные корпоративные среды могут включать тысячи API.
Чжай признает, что это ключевая проблема для данной области, но отмечает, что AgentEvolver изначально проектировался с возможностью расширения. «Поиск по чрезвычайно большим пространствам действий всегда будет создавать вычислительные трудности, но архитектура AgentEvolver обеспечивает четкий путь к масштабируемому рассуждению об инструментах в корпоративных средах», — сказал он.
Более эффективный путь к обучению агентов
Чтобы оценить эффективность своего фреймворка, исследователи протестировали его на AppWorld и BFCL v3 — двух бенчмарках, требующих от агентов выполнения длительных многошаговых задач с использованием внешних инструментов. Они использовали модели из семейства Qwen2.5 от Alibaba (с 7 млрд и 14 млрд параметров) и сравнили их производительность с базовой моделью, обученной с помощью GRPO — популярного метода обучения с подкреплением, используемого для создания моделей рассуждения вроде DeepSeek-R1.
Результаты показали, что интеграция всех трех механизмов в AgentEvolver привела к существенному приросту производительности. Для модели с 7 млрд параметров средний балл вырос на 29,4%, а для модели с 14 млрд параметров — на 27,8% по сравнению с базовым показателем. Фреймворк стабильно повышал возможности моделей в области рассуждений и выполнения задач на обоих бенчмарках. Наиболее значительное улучшение обеспечил модуль самоопроса, который автономно генерирует разнообразные обучающие задачи и напрямую решает проблему нехватки данных.
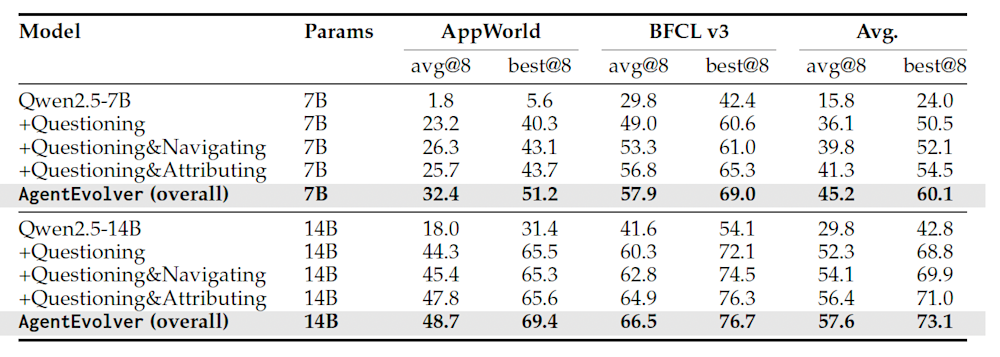
AgentEvolver превосходит базовые методы обучения с подкреплением, особенно при реализации всех трех элементов (источник: arXiv)
Эксперименты также продемонстрировали, что AgentEvolver способен эффективно синтезировать большой объем высококачественных обучающих данных. Задачи, сгенерированные модулем самоопроса, оказались достаточно разнообразными для достижения хорошей эффективности обучения даже при использовании небольшого объема данных.
Для предприятий это открывает путь к созданию агентов для специализированных приложений и внутренних рабочих процессов при минимальной потребности в разметке данных вручную. Предоставляя высокоуровневые цели и позволяя агенту генерировать собственный опыт обучения, организации могут разрабатывать кастомные ИИ-ассистенты проще и с меньшими затратами.
«Такое сочетание алгоритмического дизайна и инженерной прагматики позиционирует AgentEvolver одновременно как исследовательский инструмент и как многоразовую основу для создания адаптивных агентов с поддержкой инструментов», — резюмируют исследователи.
Глядя в будущее, исследователи ставят перед собой гораздо более масштабную цель. «Поистине «уникальная модель», способная внедриться в любую программную среду и освоить ее за одну ночь, — это, безусловно, священный Грааль агентного ИИ, — отметил Чжай. — Мы рассматриваем AgentEvolver как необходимый шаг в этом направлении». Хотя это будущее все еще требует прорывов в области рассуждений моделей и инфраструктуры, подходы, основанные на саморазвитии, прокладывают к нему дорогу.