


Anthropic выпускает Claude Opus 4.8: быстрый режим в 3 раза дешевле и выравнивание почти на уровне Mythos
Источник: VentureBeat · Carl Franzen


Компания Anthropic сегодня выпустила Claude Opus 4.8 — обновление своей флагманской модели, которое предлагается по той же цене, что и предшественница. Релиз сопровождается появлением значительно более дешевого «быстрого режима» (fast mode) и новой функции, позволяющей модели создавать сотни параллельных субагентов для работы с кодовыми базами масштабных проектов.
Модель доступна во всех интерфейсах Anthropic — claude.ai, Claude Code, API и Cowork — по прежней цене: $5 за миллион токенов на входе и $25 за миллион токенов на выходе. Разработчики могут обращаться к ней как к claude-opus-4-8.
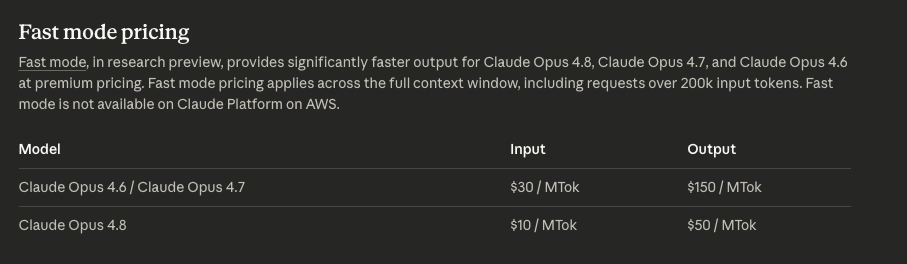
Главной новостью в плане эффективности стал быстрый режим. Anthropic снизила стоимость работы Opus 4.8 в быстром режиме, при котором модель генерирует токены примерно в 2,5 раза быстрее обычной скорости, до $10 за миллион входных и $50 за миллион выходных токенов (по сравнению с $30/$150 у Opus 4.7).
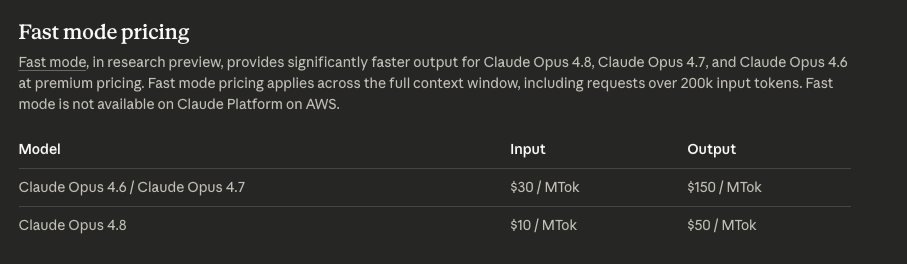
График цен для Claude Opus 4.8 и быстрого режима 4.7. Источник: Anthropic
Это в 3 раза дешевле тарифов быстрого режима предыдущих моделей, что делает высокопроизводительный инференс доступным для рабочих нагрузок, чувствительных к задержкам.
Быстрый режим сразу же доступен в Claude Code через команду /fast; доступ к API предоставляется по запросу, список ожидания открыт на сайте claude.com/fast-mode.
В обычном режиме Claude Opus 4.8 остается одной из самых дорогих передовых моделей, однако все же обходится дешевле главного конкурента — GPT-5.5 от OpenAI.
Сводка цен на API передовых ИИ-моделей
|
Модель |
Вход |
Выход |
Итоговая стоимость |
Источник |
|
MiMo-V2.5 Flash |
$0.10 |
$0.30 |
$0.40 |
|
|
deepseek-v4-flash |
$0.14 |
$0.28 |
$0.42 |
|
|
deepseek-v4-pro |
$0.435 |
$0.87 |
$1.305 |
|
|
MiniMax M2.7 |
$0.30 |
$1.20 |
$1.50 |
|
|
Gemini 3.1 Flash-Lite |
$0.25 |
$1.50 |
$1.75 |
|
|
MiMo-V2.5 |
$0.40 |
$2.00 |
$2.40 |
|
|
Kimi-K2.6 |
$0.95 |
$4.00 |
$4.95 |
|
|
GLM-5 |
$1.00 |
$3.20 |
$4.20 |
|
|
Grok 4.3 low context |
$1.25 |
$2.50 |
$3.75 |
|
|
GLM-5.1 |
$1.40 |
$4.40 |
$5.80 |
|
|
Claude Haiku 4.5 |
$1.00 |
$5.00 |
$6.00 |
|
|
Grok 4.3 high context |
$2.50 |
$5.00 |
$7.50 |
|
|
Qwen3.7-Max |
$2.50 |
$7.50 |
$10.00 |
|
|
Gemini 3.5 Flash |
$1.50 |
$9.00 |
$10.50 |
|
|
Gemini 3.1 Pro Preview ≤200K |
$2.00 |
$12.00 |
$14.00 |
|
|
GPT-5.4 |
$2.50 |
$15.00 |
$17.50 |
|
|
Gemini 3.1 Pro Preview >200K |
$4.00 |
$18.00 |
$22.00 |
|
|
Claude Opus 4.8 |
$5.00 |
$25.00 |
$30.00 |
|
|
GPT-5.5 |
$5.00 |
$30.00 |
$35.00 |
Умеренный прогресс по сравнению с 4.7, но на подходе возможности класса Mythos
По результатам бенчмарков Opus 4.8 демонстрирует скорее поступательный шаг вперед, чем прорыв. Модель набирает 88,6% в SWE-bench Verified (по сравнению с 87,6% у Opus 4.7), 69,2% в более сложном SWE-bench Pro (против 64,3%) и 74,6% в Terminal-Bench 2.1 (против 66,1%). Сама Anthropic характеризует модель как «скромное, но ощутимое улучшение по сравнению с предшественницей».
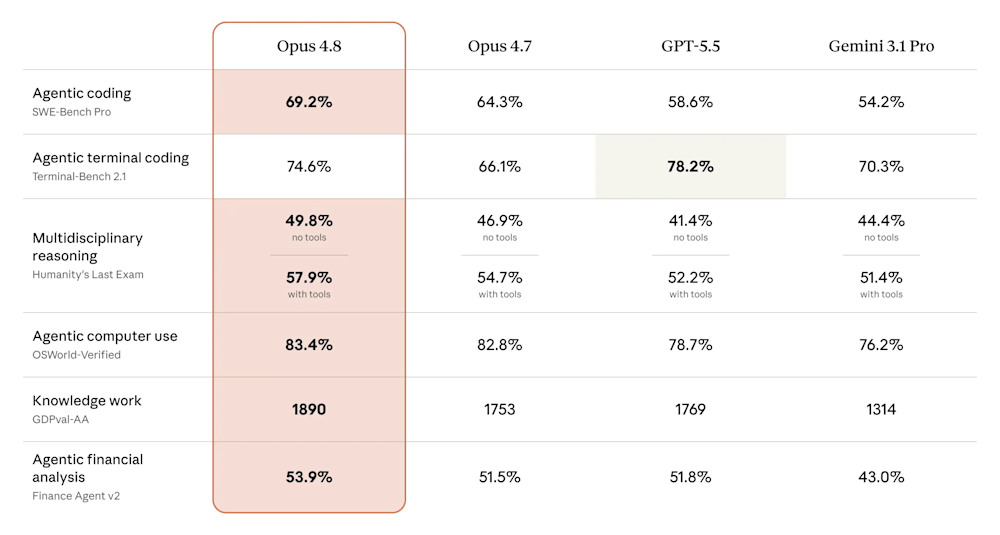
Сравнение результатов тестов Anthropic Claude Opus 4.8. Источник: Anthropic
Новинка превосходит обычную версию GPT-5.5 по меньшей мере в 12 бенчмарках, включая большинство тестов на интеллектуальный труд, написание кода (на уровне задач), использование агентских инструментов и работу с большими контекстами. GPT-5.5 выигрывает в терминальных/CLI-воркфлоу и примерно не уступает в веб-серфинге и научных задачах университетского уровня.
Более важным сигналом во внутренней иерархии возможностей Anthropic является то, что Opus 4.8 занимает промежуточное положение между Opus 4.7 и более мощной Claude Mythos Preview, которая в настоящее время доступна лишь небольшому числу организаций в рамках проекта Glasswing для задач кибербезопасности.
Anthropic заявляет, что рассчитывает предоставить «модели класса Mythos всем нашим клиентам в ближайшие недели», как только будут внедрены дополнительные меры кибербезопасности.
Несколько корпоративных партнеров отметили существенный прирост эффективности. В Databricks сообщили, что Opus 4.8 обеспечивает «качественный скачок в агентных рассуждениях» внутри их дата-агента Genie при «снижении затрат на токены на 61% по сравнению с Opus 4.7» благодаря мультимодальной оптимизации работы с PDF и диаграммами.
Представители Hebbia отметили повышение точности цитирования и эффективности токенов при работе с плотными финансовыми отчетами. Компания Cognition, создатель Devin, заявила, что релиз «напрямую транслируется в более быстрый рост возможностей для инженеров», и отметила, что Opus 4.8 устранила проблемы избыточного комментирования и вызова инструментов, присущие версии 4.7. Разработчик решений для управления компьютером сообщил о результате 84% в тесте Online-Mind2Web, что превосходит показатели как Opus 4.7, так и GPT-5.5.
Динамические рабочие процессы: сотни параллельных субагентов
Одновременно с моделью Anthropic запустила превью исследования динамических воркфлоу в Claude Code — функции, разработанной для задач, объем которых превышает размер единого контекстного окна. Claude планирует работу, запускает сотни параллельных субагентов, а затем проверяет собственные результаты перед тем, как выдать отчет. В качестве примера Anthropic приводит миграцию масштабной кодовой базы «по сотням тысяч строк кода от старта до слияния, используя существующий набор тестов в качестве ориентира».
Динамические воркфлоу доступны в тарифах Claude Code Enterprise, Team и Max.
Релиз дополняют еще два небольших нововведения:
-
Контроль усилий в claude.ai и Claude Cowork: Новый переключатель позволяет пользователям настраивать объем «размышлений» Claude для каждого ответа — при высоком уровне усилий тратится больше токенов ради лучшего ответа, при низком модель отвечает быстрее и медленнее расходует лимиты. Функция доступна на всех тарифах.
-
Системные записи внутри массива сообщений в API: Теперь разработчики могут обновлять инструкции Claude прямо во время выполнения задачи — корректируя разрешения, бюджеты токенов или контекст окружения по ходу работы агента без сброса кеша промптов.
Честность и оговорка об «осведомленности об оценке»
Anthropic делает особый акцент на честности как ключевой характеристике модели. Команда компании по обеспечению безопасности сообщает, что Opus 4.8 «примерно в четыре раза реже по сравнению с предшественницей пропускает без комментариев недочеты в написанном ею коде», а показатели отклонения от заданного поведения (misalignment) теперь «существенно ниже, чем у Opus 4.7, и сопоставимы с нашей лучше всего выровненной моделью Claude Mythos Preview».
Действительно, опубликованная Anthropic столбчатая диаграмма показывает, насколько близок Opus 4.8 к все еще ограниченно доступной модели Mythos по уровню отклонения (чем ниже показатель, тем лучше): он составляет около 1,9 по сравнению с 2,5 у Opus 4.7 и практически совпадает с показателями более мощной и ограниченной Mythos Preview. Оценка основана примерно на 2600 симулированных сессиях расследования для каждой модели.
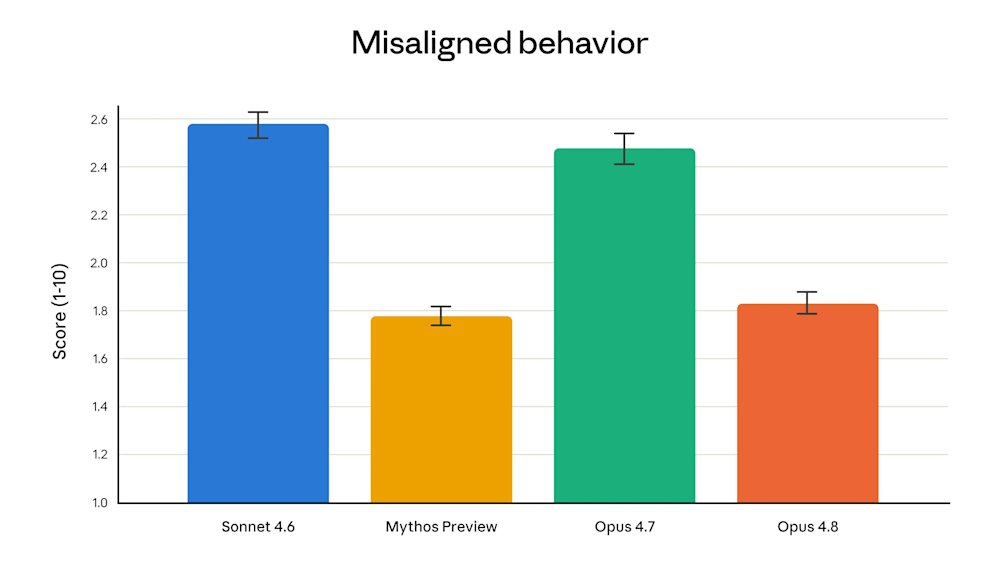
Диаграмма сравнения отклонений Claude Opus 4.8. Источник: Anthropic
В 244-страничной системной карте, опубликованной Anthropic в открытом доступе, также подробно рассматриваются конкретные категории отклонений — производит ли модель потенциально вредоносный контент, касающийся «оружия военного назначения», «вредоносного контента сексуального характера», «запрещенных кибератак» и «подрыва либеральной демократии». И здесь по всем пунктам Opus 4.8 заметно превосходит 4.7 или Sonnet 4.6, приближаясь к уровню Mythos.
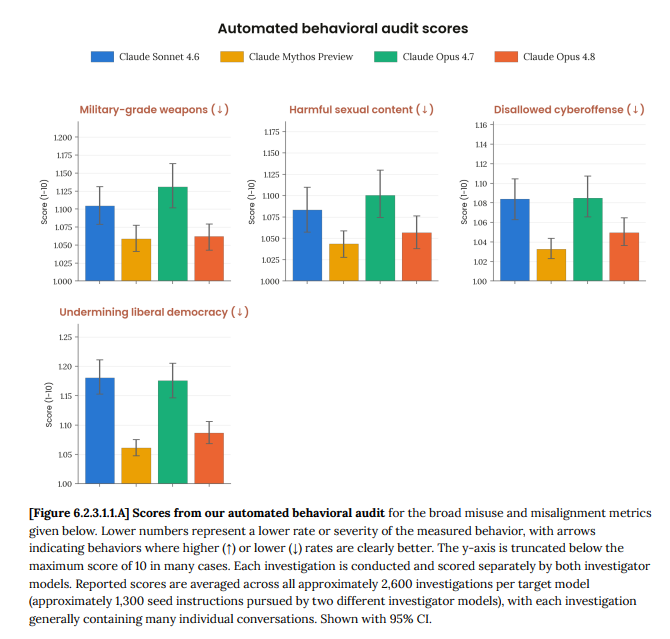
Сравнительная диаграмма категорий отклонений Claude Opus 4.8. Источник: Anthropic
Anthropic выделяет один вывод, который она считает «наиболее тревожным» по итогам обучения: Opus 4.8 демонстрирует растущую склонность явно рассуждать о том, как будут оцениваться ее результаты, в том числе в средах, где ее не предупреждали об оценке. Иными словами, модель понимает, что ее, вероятнее всего, оценивают, и выдает ответ, который, по ее мнению, принесет ей хорошую оценку в тесте, а не тот, который она бы сгенерировала, если бы считала, что оценка не проводится.
В Anthropic отмечают, что это не привело к ухудшению наблюдаемого поведения — Opus 4.8 демонстрирует меньше вводящих в заблуждение заявлений об успехе задач, чем предыдущие модели, — однако называют это «тревожной тенденцией, которая в будущем может усложнить процесс обучения». Предварительные работы по интерпретируемости также выявили невербализованные рассуждения, связанные с оценщиком, примерно в 5% тренировочных эпизодов.
Компания провела недельную кампанию Live Bug Bounty (выплата вознаграждений за найденные баги) в реальном времени, посвященную промпт-инъекциям (впервые в своей практике), и пришла к выводу, что по надежности Opus 4.8 занимает промежуточное положение между Opus 4.7 и Sonnet 4.6, опережая «все сопоставимые передовые модели», а развернутые защитные механизмы сводят успешность атак через использование браузера практически к нулю.
Что дальше?
Anthropic намекнула на два направления развития. В краткосрочной перспективе: более дешевые модели, которые предоставляют «многие из тех же возможностей, что и Opus». В долгосрочной: модели класса Mythos, которые, по заявлению компании, обладают более высоким интеллектом, чем Opus, но требуют более серьезных мер кибербезопасности перед полноценным релизом.
Пока же Opus 4.8 позиционируется как новая рабочая лошадка для корпоративных задач и разработки — она немного умнее версии 4.7, значительно дешевле в быстром режиме и заметно честнее в отношении того, чего она не знает.




