


Grok 4 Fast от xAI снижает затраты на ИИ в 64 раза


Каждую неделю появляется столько новостей об искусственном интеллекте, что за некоторыми из самых значительных достижений бывает трудно уследить.
Но новая модель Grok 4 Fast от xAI, выпущенная в прошлую пятницу, заслуживает пристального внимания со стороны предприятий и технических директоров — несмотря на продолжающиеся заявления основателя xAI Илона Маска о том, что он хочет сделать Grok более соответствующим его политическим взглядам и мировоззрению, а также на недавний скандал с «МехаГитлером» в социальной сети Маска, X.
Grok 4 Fast — это оптимизированная версия флагманской модели Grok 4 от xAI, выпущенной в июле 2025 года. Новая версия разработана для обеспечения производительности, близкой к передовому уровню, при значительно более низкой стоимости.
Созданный на той же инфраструктуре, которая обеспечивает работу самых передовых систем xAI, Grok 4 Fast уже меняет графики соотношения стоимости и производительности во всей экосистеме ИИ, как показывают новые аналитические материалы таких исследователей, как профессор Уортонской школы бизнеса Пенсильванского университета Итан Моллик, и сторонняя компания по бенчмаркингу ИИ Artificial Analysis.
Для предприятий этот запуск означает две вещи:
-
Стоимость передового рассуждающего ИИ — моделей, которые «обдумывают» свои ответы перед выдачей пользователям с целью выявления ошибок и повышения точности — продолжает стремительно падать.
-
xAI делает ставку на то, что в будущем эффективность и «плотность интеллекта» будут иметь такое же значение, как и чистый размер модели.
Согласно официальной карточке модели, Grok 4 Fast также представляет режим «пропуска рассуждений» для приложений с ультранизкой задержкой, позволяя предприятиям при необходимости жертвовать глубиной анализа ради скорости.
Производительность: результаты на уровне передовых моделей при меньшем количестве токенов
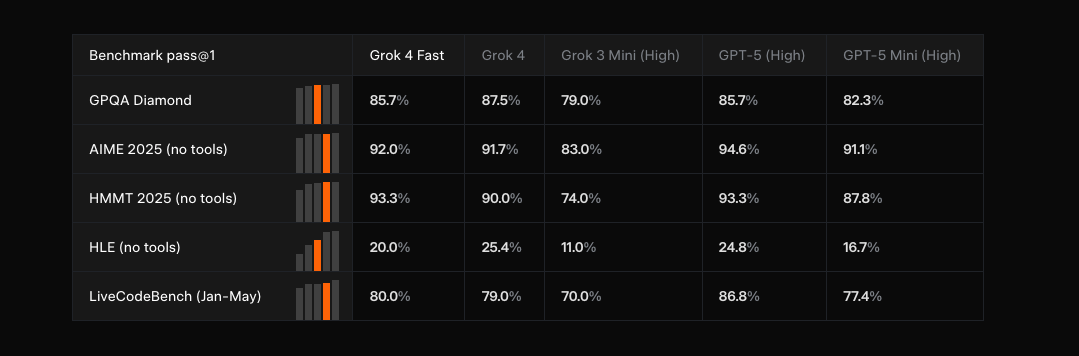
Согласно официальному анонсу xAI, Grok 4 Fast не уступает или почти не уступает Grok 4 в большинстве основных бенчмарков, используя при этом примерно на 40% меньше «токенов размышления» (thinking tokens).
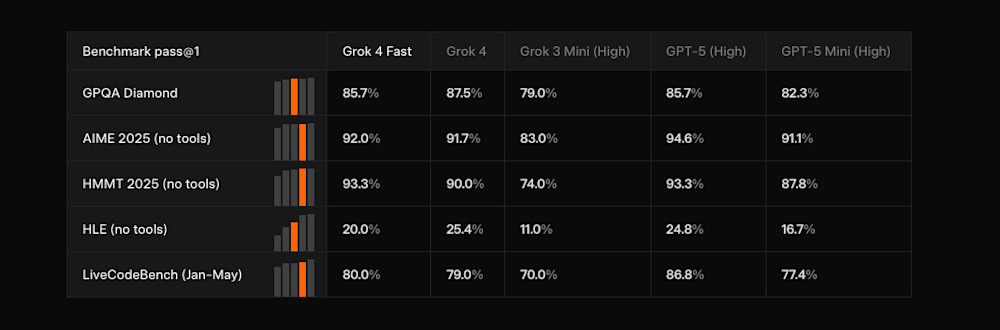
Бенчмарки Grok 4 Fast. Источник: xAI
Токены, разумеется, представляют собой числовые представления слов и фрагментов слов, строк кода и других единиц информации, которые большая языковая модель (LLM) может принимать и выдавать — это «родной язык» LLM. «Токены размышления» генерируются в процессе «цепочки рассуждений» (chain-of-thought) модели, поэтому они могут даже не выводиться в качестве ответа пользователю, но при этом все равно потребляют энергию и увеличивают расходы для пользователей — поскольку большинство провайдеров ИИ, включая xAI, взимают плату за доступ разработчиков к своим моделям через программный интерфейс приложения (API) из расчета стоимости за миллион токенов.
Но об этом мы поговорим чуть позже. Вернемся к бенчмаркам: например, в математическом тесте AIME 2025 Grok 4 Fast набрал 92% против 91,7% у Grok 4; в GPQA Diamond — 85.7% против 87.5%. Бенчмарки задач по просмотру веб-страниц и поиску также демонстрируют улучшения: Grok 4 Fast набрал 74% в тесте xAI X Bench Deepsearch (по сравнению с 66% у Grok 4).
Независимые эксперты подтверждают эти заявления.
Artificial Analysis ставит Grok 4 Fast на первое место в своем Индексе интеллекта из расчета цены за миллион токенов — он в 64 раза дешевле ранних передовых моделей, таких как o3 от OpenAI на момент запуска, и примерно в 12 раз дешевле текущих расценок o3.
На графике, опубликованном Молликом в X, видно, что Grok 4 Fast находится в самом дальнем правом углу кривой GPQA/стоимость, что указывает на новый рубеж эффективности.
В карточке модели Grok 4 от xAI подчеркивается обучение модели с использованием «масштабируемого обучения с подкреплением для максимизации плотности интеллекта», а также ее целенаправленное пост-обучение использованию инструментов и демонстрациям безопасности.
Стоимость и лицензирование
Grok 4 Fast — это проприетарная модель (не с открытым исходным кодом), доступная через API xAI, OpenRouter и Vercel AI Gateway. xAI разделила релиз на две редакции (SKU):
|
Модель |
Входные токены (<128k) |
Входные токены (≥128k) |
Выходные токены (<128k) |
Выходные токены (≥128k) |
Кэшированный ввод |
|
grok-4-fast-reasoning |
$0.20 / 1M |
$0.40 / 1M |
$0.50 / 1M |
$1.00 / 1M |
$0.05 / 1M |
|
grok-4-fast-non-reasoning |
same |
same |
same |
same |
same |
Все версии поддерживают контекстное окно в 2 миллиона токенов, что значительно больше, чем у большинства коммерческих моделей. Такая ценовая политика подрывает позиции других моделей с «индексом интеллекта >60» и позволяет предприятиям выполнять более тяжелые рабочие нагрузки (юридический анализ, разработку программного обеспечения, техподдержку, расширенный поиск) с гораздо меньшими предельными затратами.
И «grok-4-fast-reasoning», и «grok-4-fast-non-reasoning» имеют ограничения в 4 миллиона токенов в минуту и 480 запросов в минуту (RPM) при контекстном окне в 2 миллиона токенов.
xAI также предлагает опцию кэшированных входных токенов по цене $0.05 за миллион, что позволяет дополнительно снизить затраты при повторяющихся запросах и рабочих нагрузках с дополненной генерацией (RAG).
Старые модели Grok стоят значительно дороже: Grok 4 (0709) оценивается в $3.00 за ввод / $15.00 за вывод на миллион токенов при контексте всего в 256k — что подчеркивает колоссальное преимущество Grok 4 Fast в соотношении цены и производительности.
Интересно, что в документации к своему API xAI также заявляет, что будет штрафовать пользователей каждый раз, когда «система сочтет запрос нарушающим наши правила использования», а именно взимать «штраф в размере $0.05 за запрос, нарушающий правила использования».
Предприятиям, планирующим развертывание в больших объемах, следует учитывать, что региональные эндпоинты и лимиты запросов для некоторых устаревших мультимодальных моделей различаются, однако Grok 4 Fast доступен по всему миру с едиными лимитами.
В карточке модели четко указано, что API принудительно добавляет фиксированный префикс системного промпта, в который встроена политика безопасности xAI по умолчанию; пользовательские системные сообщения от корпоративных клиентов добавляются к этому промпту безопасности, а не заменяют его.
Ключевые отличия для корпоративного использования
1. Единые режимы с рассуждениями и без них
Предыдущие модели xAI требовали раздельных весов для задач, требующих рассуждений, и быстрых ответов. Grok 4 Fast объединяет их в единой архитектуре, сокращая задержки и упрощая интеграцию. Разработчики по-прежнему могут настраивать систему с помощью промптов для достижения большей скорости или глубины.
В карточке модели также отмечается, что включение режима рассуждений обычно снижает уровень нечестивости и угодничества (sycophancy) по сравнению с режимом без рассуждений, что является важным моментом для предприятий, которым требуется фактическая точность.
2. Передовой поиск и агентные возможности
Обученный сквозному обучению с подкреплением на использовании инструментов, Grok 4 Fast может просматривать веб-страницы, выполнять запросы в X в реальном времени, переходить по ссылкам, обрабатывать мультимедиа и синтезировать полученные данные.
Бенчмарки, такие как BrowseComp и X Browse, показывают, что Grok 4 Fast превосходит Grok 4 в многошаговом поиске.
Тем не менее, в карточке модели прямо указано, что эти продвинутые «агентные» возможности создают дополнительные риски (например, автономные действия во вредоносных целях), для измерения и минимизации которых xAI использует бенчмарки AgentHarm и AgentDojo.
В AgentHarm модель выполнила лишь около 8–10% вредоносных агентных задач в зависимости от режима, а в AgentDojo процент успешных атак упал до 0–3%. На практике это означает, что Grok 4 Fast в значительной степени способен отклонять или нейтрализовать вредоносные или деструктивные промпты даже в условиях противодействия, что свидетельствует о высокой степени надежности для корпоративного развертывания.
Тем не менее, как отмечается в карточке модели, эти оценки получены в лабораторных условиях; при развертывании в продакшене все равно следует предусмотреть собственные элементы контроля доступа, аудита и ограничения частоты запросов для контекстов, критически важных с точки зрения безопасности.
3. Большое контекстное окно
Обладая ошеломляющим объемом в 2 миллиона токенов, Grok 4 Fast опережает практически все LLM по количеству информации, которой могут обмениваться пользователь и модель ИИ в рамках одного взаимодействия типа «ввод/вывод».
Например, флагманская модель GPT-5 от OpenAI предлагает всего 256 000 токенов, в то время как Google Gemini 2.5 Pro по-прежнему ограничена 1 миллионом, несмотря на обещание Google удвоить этот показатель, что позволило бы лишь сравняться с Grok 4 Fast.
Два миллиона токенов грубо эквивалентны 3000 страницам текста — примерно размеру 10 книг, и все это может быть передано за один сеанс ввода/вывода!
Это означает, что Grok 4 Fast может обрабатывать полные базы знаний, кодовые базы или юридические документы, что делает его особенно подходящим для корпоративного управления знаниями, крупномасштабного поиска или конвейеров дополненной генерации (RAG) — последнего как распространенного метода безопасного подключения сторонних моделей ИИ (таких как Grok 4 Fast и ее конкуренты) к корпоративным базам знаний и данным.
4. Цена и эффективность токенов
Использование на 40% меньшего количества токенов размышления при тех же баллах означает меньшие затраты на инференс и потенциально меньшую задержку. Это крайне важно для SaaS или клиентских приложений, зависящих от высоких объемов запросов.
Недостатки и особенности
Показатели соответствия SpeechMap, которые измеряют, как часто модель генерирует спорные высказывания по указанию пользователя, снизились.
Независимый оценщик SpeechMap.AI сообщает, что Grok 4 Fast набрал всего 77,5%–77,9% соответствия по сравнению с 98% у Grok 4 и >90% у конкурирующих моделей Sonoma.
Инженер xAI Норман Му подтвердил в X, что более высокие показатели отказов были «непреднамеренным побочным эффектом» нового обучения по предотвращению злоупотреблений, и пообещал улучшения. Корпоративным клиентам, работающим в регулируемых или чувствительных областях, следует тщательно тестировать соблюдение промптов.
GPQA Diamond, вероятно, насыщен. Аналитики отмечают, что ведущие модели группируются около верхних строчек оценок GPQA Diamond, что позволяет предположить, что этот бенчмарк больше не может различать качество рассуждений передовых моделей. Предприятиям следует дополнить его собственными тестами для конкретных доменов.
Задержка и стабильность. Хотя Grok 4 Fast позиционируется как «быстрый», xAI не опубликовала полные метрики токенов в секунду. Предприятиям с жесткими требованиями реального времени следует протестировать пропускную способность под нагрузкой. Artificial Analysis показывает, что Grok 4 Fast входит в число самых быстрых моделей по количеству обрабатываемых токенов в секунду — 227 т/с, однако все же занимает третье место после модели с открытым исходным кодом GPT-oss-120b от OpenAI и Gemini 2.5 Pro от Google.
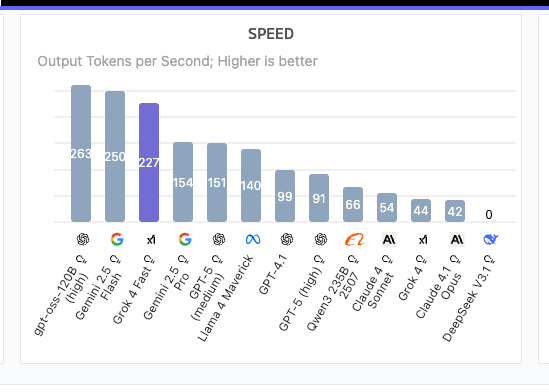
Скорость различных LLM по количеству генерируемых токенов в секунду. Источник: Artificial Analysis
Лицензирование и поддержка. На момент запуска Grok 4 Fast широко доступен (даже для бесплатных пользователей на grok.com), но соглашения об уровне обслуживания (SLA) корпоративного класса или управляемые развертывания могут отставать от развертывания API. Цены по окончании ознакомительного периода могут измениться.
Дополнительные уровни безопасности. В карточке модели подчеркиваются встроенные фильтры отказов и ввода Grok 4 Fast для контента высокого риска — включая химические, биологические, радиологические, ядерные, кибератаки и запросы, связанные с CSAM (материалами о сексуальном насилии над детьми), — и демонстрируется нулевой процент ответов на такие вредоносные запросы при настройках по умолчанию.
В ней также сообщается о значительно более низких показателях успешности атак в тестах на внедрение промптов AgentDojo (0.00–0.03), что может дать предприятиям больше уверенности в производственных средах.
История масштабирования: не только грубая сила
Grok 4 Fast работает на массивном кластере Colossus от xAI в Мемфисе, который, как сообщается, включает в себя сотни тысяч высокопроизводительных графических процессоров, но его определяющей характеристикой является эффективность, а не чистый масштаб.
Объединяя режимы рассуждений и обучая модель использованию инструментов, xAI пытается делать больше с меньшими вычислительными затратами при инференсе. Это ключевой сигнал для индустрии ИИ: следующее конкурентное преимущество может заключаться в оптимизации времени тестирования, оркестровке инструментов и более умных архитектурах, а не просто в выделении большего количества GPU для решения проблемы.
Карточка модели также подчеркивает шаги xAI в направлении прозрачности — публикацию системных промптов на GitHub и подробное описание рецепта обучения, — что может успокоить предприятия, которым требуется возможность аудита или доказательства соответствия требованиям регуляторов.
Что предприятиям следует сделать прямо сейчас
-
Проведите пилотное тестирование задач с большими объемами. Цены на токены Grok 4 Fast и его длинное контекстное окно делают модель привлекательной для ресурсоемких пакетных операций, таких как анализ контрактов, обогащение данных и проверка кода.
-
Оцените соответствие требованиям и поведение при отказах. Если ваш бизнес работает в регулируемых секторах, запустите собственные тесты в стиле SpeechMap для оценки показателей отказов и предвзятости.
-
Сравните задержку и пропускную способность. Используйте свои реальные рабочие нагрузки для измерения токенов в секунду и проверьте, соответствует ли Grok 4 Fast требованиям SLA.
-
Спланируйте стратегии с использованием нескольких моделей. Учитывая различия между режимами с рассуждениями и без них, а также быстро меняющийся ландшафт бенчмарков, рассмотрите возможность сохранения по крайней мере одной запасной модели в продакшене.
— Рассмотрите возможность включения «режима рассуждений» с явными инструкциями по честности для приложений, требующих высокой фактической точности, поскольку внутренние тесты xAI показывают более низкие показатели дезинформации в таких условиях.
Итог
Grok 4 Fast — это не просто более дешевый Grok 4, это сигнал о том, что рассуждения передового уровня становятся массовым товаром. Благодаря своему массивному контекстному окну, единой архитектуре и обучению с подкреплением на использовании инструментов, модель создана для обслуживания предприятий, которым требуются масштабные и высококонтекстные задачи за малую долю прежних затрат.
Главная предостерегающая оговорка касается поведенческой стабильности и частоты отказов, которые, как признает xAI, все еще настраиваются.
Однако для большинства корпоративных вариантов использования Grok 4 Fast представляет собой один из самых убедительных вариантов экономической эффективности на современном рынке — это шанс интегрировать передовые рассуждения в клиентские сервисы или внутренние рабочие процессы без бюджетов передового уровня.
И в отличие от многих конкурентов, Grok 4 Fast поставляется с публично задокументированным подходом к безопасности, включающим бенчмарки потенциала злоупотреблений, дезинформации, политической предвзятости и знаний двойного назначения, что дает руководителям предприятий больше понимания компромиссов, лежащих в основе производительности модели.




