Справочник LinkedIn по генеративному ИИ: как компания масштабировала поиск людей до 1,3 миллиарда пользователей


LinkedIn запускает новую функцию поиска людей на базе искусственного интеллекта. Этот релиз состоялся после долгого ожидания того, что должно было стать естественным применением генеративного ИИ.
Это произошло ровно через три года после запуска ChatGPT и через полгода после того, как LinkedIn представила поиск работы с поддержкой ИИ. Для технических руководителей этот временной горизонт иллюстрирует важный урок для бизнеса: внедрение генеративного ИИ в реальных корпоративных условиях — задача сложная, особенно при масштабе в 1,3 миллиарда пользователей. Это медленный, сложный процесс прагматичной оптимизации.
Следующий материал основан на нескольких эксклюзивных интервью с командой по продуктам и разработке LinkedIn, стоявшей за этим запуском.
Во-первых, вот как работает продукт: теперь пользователь может ввести в поисковую строку LinkedIn запрос на естественном языке, например: «Кто разбирается в лечении рака?»
Старый поиск LinkedIn, основанный на ключевых словах, зашел бы в тупик. Он искал бы только упоминания слова «рак». Если бы пользователь хотел получить более точный результат, ему пришлось бы запускать отдельные жесткие поисковые запросы для слов «рак» и «онкология», а затем вручную пытаться объединить результаты.
Однако новая система на базе ИИ понимает намерение поиска, поскольку лежащая в ее основе языковая модель (LLM) улавливает семантическое значение. Она распознает, например, что понятие «рак» концептуально связано с «онкологией» и, пусть менее напрямую, с «геномными исследованиями». В результате система выдает гораздо более релевантный список людей, включая ведущих онкологов и исследователей, даже если в их профилях не используется точное слово «рак».
Кроме того, система балансирует эту релевантность с полезностью. Вместо того чтобы просто показывать ведущего онколога мира (который может оказаться недоступным контактом третьей степени), она также оценит, кто в вашей близкой сети — например, контакт первой степени — является «достаточно релевантным» и может послужить надежным мостиком к этому эксперту.
Пример можно посмотреть в видео ниже.
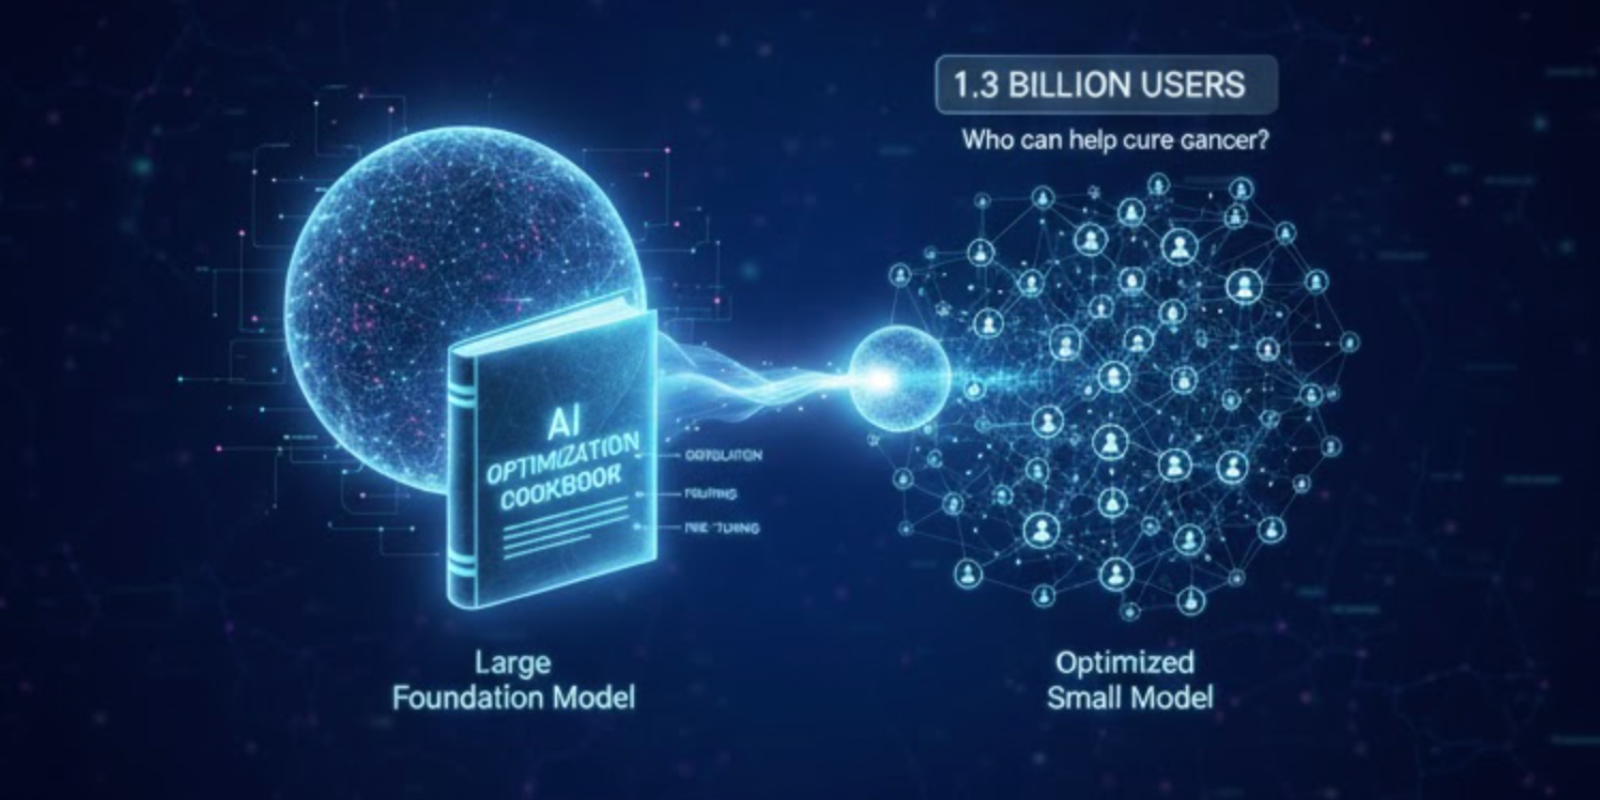
Пожалуй, еще более важный урок для корпоративных практиков заключается в «поваренной книге», которую разработал LinkedIn: это тиражируемый многоэтапный конвейер дистилляции, совместного проектирования и непрерывной оптимизации. LinkedIn пришлось довести этот подход до совершенства на одном продукте, прежде чем переходить к другому.
«Не пытайтесь делать все и сразу», — пишет Вэньцзин Чжан (Wenjing Zhang), вице-президент по разработке в LinkedIn, в своей публикации о запуске продукта, а также в интервью VentureBeat на прошлой неделе. Она отмечает, что более раннее «обширное стремление» создать единую систему для всех продуктов LinkedIn «застопорило прогресс».
Вместо этого LinkedIn сосредоточился на том, чтобы сначала завоевать одну вертикаль. Успех ранее запущенного сервиса поиска работы с ИИ — благодаря которому соискатели без четырехлетнего высшего образования стали на 10% чаще получать предложения о работе, по словам вице-президента по разработке продуктов Эррана Бергера (Erran Berger) — стал готовым чертежом.
Теперь компания применяет эту концепцию к гораздо более масштабной задаче. «Одно дело — уметь делать это для десятков миллионов вакансий, — сказал Бергер в интервью VentureBeat. — И совсем другое — справляться с аудиторией, превышающей миллиард участников».
Для разработчиков корпоративного ИИ опыт LinkedIn служит техническим руководством к тому, что на самом деле требуется для перехода от успешного пилотного проекта к продукту масштабом в миллиард пользователей.
Новая задача: граф с 1,3 миллиарда участников
Продукт для поиска работы создал надежный рецепт, на который смог опереться новый поиск людей, пояснил Бергер.
Рецепт начинался с «эталонного набора данных» (golden data set), состоящего всего из нескольких сотен или тысяч реальных пар «запрос-профиль», тщательно оцененных в соответствии с подробным документом по «политике продукта» на 20–30 страницах. Для масштабирования этого набора при обучении LinkedIn использовал этот небольшой эталонный набор, чтобы заставить крупную базовую модель сгенерировать огромный объем синтетических обучающих данных. Эти синтетические данные использовались для обучения модели «политики продукта» с 7 миллиардами параметров — высокоточной модели оценки релевантности, которая работала слишком медленно для «живого» производства, но идеально подходила для обучения моделей меньшего размера.
Тем не менее, команда столкнулась с трудностями на раннем этапе. В течение 6–9 месяцев они пытались обучить единую модель, которая могла бы одновременно обеспечивать строгое соблюдение политик (релевантность) и учитывать сигналы пользовательской активности. Момент озарения наступил, когда они поняли, что проблему нужно разделить. Они дистиллировали модель политики с 7 млрд параметров в учительскую модель с 1,7 млрд параметров, ориентированную исключительно на релевантность. Затем они объединили ее с отдельными учинками-моделями, обученными предсказывать конкретные действия пользователей, такие как отклики на вакансии для продукта по поиску работы либо добавление в контакты и подписку для поиска людей. Этот «ансамбль учителей» выдавал мягкие вероятностные оценки, которые конечная модель-ученик училась имитировать с помощью функции потерь дивергенции Кульбака — Лейблера (KL divergence loss).
Полученная архитектура работает как двухэтапный конвейер. Сначала более крупная модель с 8 млрд параметров выполняет широкий поиск (retrieval), закидывая удочку пошире, чтобы извлечь кандидатов из графа. Затем высокодистиллированная модель-ученик берет на себя задачу детального ранжирования. Если в продукте для поиска работы была успешно развернута модель-ученик с 0,6 млрд (600 млн) параметров, то новый поиск людей потребовал еще более агрессивного сжатия. Как отмечает Чжан, команда сократила свою новую модель-ученика с 440 млн всего до 220 млн параметров, обеспечив необходимую скорость для 1,3 миллиарда пользователей при потере релевантности менее чем на 1%.
Однако применение этого подхода к поиску людей разрушило старую архитектуру. Новая задача включала в себя не только ранжирование, но и извлечение данных (retrieval).
«Миллиард записей, — сказал Бергер, — это совершенно другой зверь».
Предыдущий поисковый стек команды был построен на центральных процессорах (CPU). Чтобы справиться с новым масштабом и требованиями к задержке для «быстрого» поиска, команде пришлось перенести индексацию на инфраструктуру на базе графических процессоров (GPU). Это был фундаментальный архитектурный сдвиг, который не требовался для продукта по поиску работы.
С организационной точки зрения LinkedIn выиграл от использования нескольких подходов. Какое-то время в LinkedIn существовало две разные команды — по поиску работы и по поиску людей, — которые пытались решить проблему параллельно. Но как только команда по поиску работы добилась прорыва с помощью метода дистилляции на основе правил, Бергер и его руководство вмешались. Они привлекли архитекторов победного решения по поиску работы — руководителя отдела продуктов Рохана Раджива (Rohan Rajiv) и руководителя разработки Вэньцзин Чжан — чтобы напрямую перенести их «поваренную книгу» в новую предметную область.
Дистилляция ради 10-кратного роста пропускной способности
После решения проблемы извлечения данных команда столкнулась с проблемами ранжирования и эффективности. Именно здесь «поваренная книга» была адаптирована с помощью новых агрессивных методов оптимизации.
В технической статье Чжан приводятся конкретные детали, которые оценят наши читатели-инженеры по искусственному интеллекту. Одной из наиболее значительных оптимизаций стал размер входных данных.
Чтобы подавать данные в модель, команда обучила еще одну LLM с использованием обучения с подкреплением (RL) для единственной цели: суммировать входной контекст. Эта модель-«суммаризатор» смогла сократить размер входных данных модели в 20 раз при минимальной потере информации.
Каков суммарный результат модели на 220 млн параметров и 20-кратного сокращения входных данных? 10-кратное увеличение пропускной способности ранжирования, что позволило команде эффективно обслуживать огромную базу пользователей с помощью этой модели.
Прагматизм вместо хайпа: создание инструментов, а не агентов
В ходе наших бесед Бергер твердо стоял на своем в отношении еще одного момента, который может привлечь внимание людей: реальная ценность для бизнеса сегодня заключается в совершенствовании рекомендательных систем, а не в погоне за «хайпом вокруг агентов». Он также отказался говорить о конкретных моделях, которые компания использовала для поиска, намекнув, что это практически не имеет значения. Компания выбирает те модели, которые считает наиболее эффективными для конкретной задачи.
Новый поиск людей на базе ИИ — это воплощение философии Бергера о том, что лучше сначала оптимизировать рекомендательную систему. Архитектура включает в себя новый «слой интеллектуальной маршрутизации запросов», как пояснил Бергер, который сам по себе работает на базе LLM. Этот маршрутизатор прагматично решает, должен ли запрос пользователя (например, «эксперт по доверию») поступать в новый семантический стек на естественном языке или в старый, надежный лексический поиск.
Вся эта сложная система спроектирована так, чтобы быть «инструментом», который будет использовать будущий агент, а не самим агентом.
«Агентные продукты хороши ровно настолько, насколько хороши инструменты, которые они используют для решения задач людей, — сказал Бергер. — У вас может быть лучшая в мире модель рассуждений, но если вы пытаетесь использовать агента для поиска людей, а сам поисковый движок работает плохо, вы ничего не добьетесь».
Теперь, когда поиск людей запущен, Бергер намекнул, что в один прекрасный день компания предложит агентов для его использования. Однако он не стал вдаваться в подробности сроков. Он также сообщил, что рецепт, использованный для поиска работы и людей, будет внедрен и в другие продукты компании.
Для предприятий, формирующих собственные дорожные карты в сфере ИИ, руководство LinkedIn выглядит предельно ясно:
-
Будьте прагматичны: не пытайтесь объять необъятное. Завоюйте одну вертикаль, даже если на это уйдет 18 месяцев.
-
Кодифицируйте «поваренную книгу»: превратите эту победу в повторяемый процесс (документы по политикам, конвейеры дистилляции, совместное проектирование).
-
Неустанно оптимизируйте: реальный 10-кратный прирост достигается после создания первоначальной модели — за счет прунинга (сокращения сети), дистилляции и творческих оптимизаций, таких как суммаризатор, обученный с помощью обучения с подкреплением (RL).
Опыт LinkedIn показывает, что в реальном корпоративном ИИ упор на конкретные модели или классные агентские системы должен отойти на второй план. Прочное стратегическое преимущество проистекает из освоения конвейера — «ИИ-нативной» поваренной книги совместного проектирования, дистилляции и безжалостной оптимизации.
(От редакции: в скором времени мы опубликуем полноценный подкаст с Эрраном Бергером из LinkedIn в ленте подкастов VentureBeat, где подробно разберем эти технические детали.)